Wie ich als Nicht-Programmierer eine eigene SEO-Wissensbibliothek gebaut habe
Zuletzt aktualisiert:
Was mache ich mit mehreren hundert SEO-Quellen, wenn ich ungefähr weiß, wer etwas veröffentlicht hat, die entscheidende Stelle allerdings nicht mehr finde? Vor dieser Frage stand ich im Frühjahr 2026. Über die Jahre hatten sich bei mir Fachartikel, YouTube-Transkripte, Patente, Research Papers, Vorträge und PDFs angesammelt. Gelesen hatte ich einen großen Teil davon. Durchsuchen konnte ich diesen Bestand jedoch nur Datei für Datei.
Bei 50 Dokumenten funktionierte meine Ablage noch einigermaßen. Mit mehreren hundert Quellen wurde aus einer konkreten Fachfrage schnell eine längere Suche. Besonders ärgerlich war das bei Aussagen, die ich prüfen wollte. Hierfür benötigte ich keine allgemeine Zusammenfassung, sondern den betreffenden Absatz samt Dokument und Herkunft.
Deswegen habe ich eine lokale SEO-Wissensbibliothek gebaut. Sie durchsucht meine Quellen nach Begriffen und Bedeutungen, zeigt die gefundenen Textstellen an und ergänzt den Rohbestand um ein gepflegtes Wiki. Eine Schwierigkeit gab es dabei allerdings: Ich kann fachlich mit den Inhalten arbeiten, bin aber kein Programmierer.
Meine Anforderungen an die Wissensbibliothek
Für meine SEO-Fachartikel und Studien auf patrickstolp.de arbeite ich möglichst nah an den ursprünglichen Quellen. Hierzu zählen Forschungsarbeiten, Patente, Gerichtsunterlagen, offizielle Dokumentationen und Originalveröffentlichungen von Personen, deren Modelle ich beschreibe.
Bei einer Recherche brauche ich konkrete Ergebnisse:
- eine konkrete Aussage in der ursprünglichen Quelle finden,
- mehrere Erklärungen zu demselben SEO-Konzept vergleichen und
- erkennen, wenn eine spätere Veröffentlichung einer älteren Quelle widerspricht.
Ein Chat mit hochgeladenen Dokumenten löst davon zunächst die Suche innerhalb des jeweiligen Uploads. Mein Quellenbestand sollte allerdings dauerhaft lokal erhalten bleiben. Außerdem wollte ich den Suchindex selbst aktualisieren, Wiki-Änderungen nachvollziehen und dieselbe Bibliothek mit verschiedenen KI-Agenten verwenden können. Dieser Anwendungsfall ist enger als die allgemeine Frage, ob ChatGPT, Claude oder NotebookLM Dokumente zusammenfassen können. Die Funktionen dieser Produkte verändern sich zudem regelmäßig, weshalb daraus kein dauerhafter Produktvergleich entsteht.
RAG statt eines eigenen Sprachmodells
Zu Beginn dachte ich über ein eigenes KI-Modell nach, das nur meine Quellen kennt. Im Gespräch mit Claude wurde allerdings schnell klar, dass ein trainiertes Modell mein eigentliches Problem nicht löst. Auch dieses Modell müsste bei einer Fachfrage relevante Informationen finden. Training, Betrieb und Evaluation wären für meinen Zweck zusätzlich unverhältnismäßig aufwendig gewesen.
Benötigt habe ich stattdessen ein Suchsystem, das einem Sprachmodell die passenden Quellenstellen zusammen mit meiner Frage bereitstellt. Dieses Grundmuster wird heute meist Retrieval-Augmented Generation, kurz RAG, genannt. Das RAG-Paper von Lewis et al. aus dem Jahr 2020 verbindet ein generatives Modell mit einem externen, durchsuchbaren Wissensbestand. Inzwischen wird der Begriff für unterschiedliche praktische Architekturen verwendet. Gemeinsam ist ihnen, dass externe Informationen abgerufen werden und anschließend in die Verarbeitung einer Anfrage einfließen.
Meine Bibliothek folgt diesem Prinzip, ist allerdings kein Nachbau des Forschungsmodells aus dem Paper. Ebenso wenig lässt sich aus ihrem Aufbau auf die vollständige Architektur von Google, ChatGPT Search oder anderen kommerziellen Suchsystemen schließen. Den Unterschied zwischen Retrieval und generierter Antwort erkläre ich ausführlicher in meinem Artikel über Vektoren, RAG und Query Fan-out in der KI-Suche.
364 Dateien und 30.831 durchsuchbare Textabschnitte
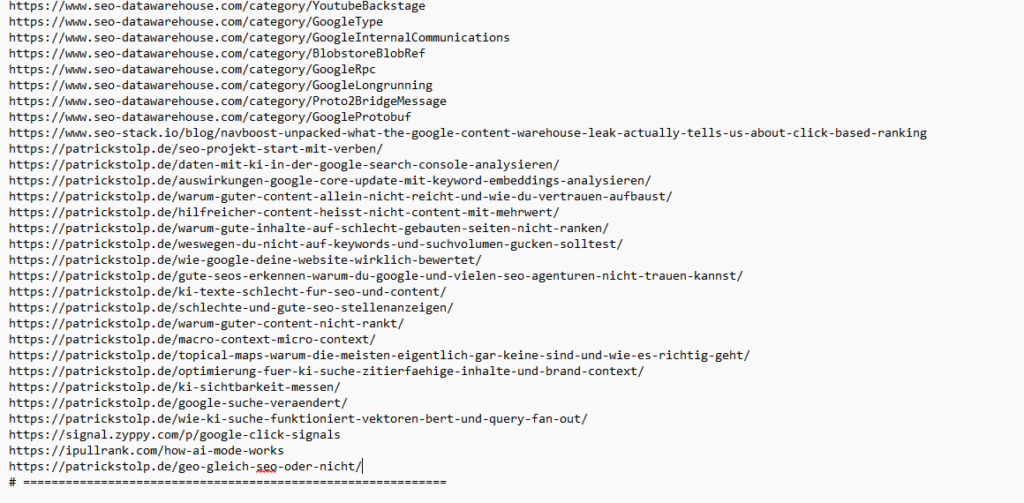
Am 29. August 2026 enthält die Bibliothek 364 Rohdateien mit insgesamt rund 15,3 Megabyte Text. Für die Suche wurden daraus 30.831 Abschnitte, sogenannte Chunks, indexiert. Das aktive Wiki umfasst 31 Seiten. Weitere fünf Dateien gehören zur Versionshistorie.
Diese Zahlen beschreiben lediglich den aktuellen Bestand. Sie sagen nichts darüber aus, ob jede Quelle fachlich gut, jeder Chunk passend geschnitten oder jede Wiki-Seite aktuell ist. Für eine belastbare Recherche zählt daher die Qualität der gefundenen Stelle und ihrer Herkunft stärker als die Größe der Sammlung.
Begriffssuche und Vektorsuche ergänzen sich
Stelle ich eine Frage, kombiniert die Bibliothek eine lexikalische Suche mit einer semantischen Vektorsuche. Die Begriffssuche arbeitet mit BM25. Sie ist besonders nützlich, wenn ich nach einem Eigennamen, einer Patentnummer oder einem seltenen Fachbegriff wie NavBoost suche.
Die Vektorsuche verwendet sogenannte Embeddings. Dabei werden Frage und Textabschnitte als Zahlenfolgen dargestellt, sodass auch inhaltlich ähnliche Passagen ohne dieselben Wörter gefunden werden können. Eine deutsche Frage kann beispielsweise zu einer englischen Quelle passen. Und eine Suche nach der fachlichen Tiefe einer Website findet womöglich Abschnitte, in denen von Topical Authority oder Site Focus die Rede ist.
Beide Verfahren haben unterschiedliche Schwächen. Eine reine Begriffssuche kann sprachlich abweichende Erklärungen übersehen. Eine semantische Suche kann dagegen einen thematisch ähnlichen Abschnitt hoch einstufen, obwohl er meine konkrete Frage nicht beantwortet. Die Elastic-Erklärung zur Hybrid Search beschreibt diese Verbindung aus lexikalischer Präzision und semantischer Ähnlichkeit allgemein. In meiner Bibliothek werden die Kandidaten beider Suchwege zusammengeführt.
Ein Cross-Encoder sortiert die Fundstellen neu
Nach der ersten Suche bewertet ein Cross-Encoder die möglichen Fundstellen noch einmal im Verhältnis zur vollständigen Frage. Hierdurch soll ein Absatz, der lediglich denselben Fachbegriff enthält, hinter einer Passage landen, die den gesuchten Zusammenhang tatsächlich erklärt.
Auch dieses Reranking garantiert keine richtige Auswahl. Der relevante Absatz kann fehlen, ein ungeeigneter Chunk kann zu weit oben stehen und mehrere Quellen können sich widersprechen. Deshalb zeigt mir das System Dokument, Abschnitt und Herkunft an. Die Ausgabe ist für mich der Beginn der fachlichen Prüfung und nicht deren Ergebnis.
Das Wiki bewahrt bereits erarbeitete Zusammenhänge
Mit der Suche war mein Problem nur teilweise gelöst. Bei jeder neuen Frage beginnt ein Suchsystem erneut mit einzelnen Fundstellen. Bereits erarbeitete Definitionen, Widersprüche und Querverbindungen bleiben dadurch nicht automatisch als strukturierter Wissensstand erhalten.
Deswegen liegt zwischen Rohquellen und Recherche ein Wiki aus Markdown-Dateien. Jede Seite behandelt ein SEO-Konzept, nennt verwendete Quellen und verweist auf verwandte Themen. Wenn eine neue Veröffentlichung hinzukommt, kann ein Agent prüfen, welche vorhandenen Seiten betroffen sind. Eine Ergänzung wird mit Datum und Quellenbezug gespeichert, sodass ältere Fassungen in der Historie erhalten bleiben.
Claude und Codex dürfen das Wiki nicht ungefragt verändern. Ich stoße die Bearbeitung an, kontrolliere die konkrete Änderung und entscheide anschließend, was übernommen wird.
Für die Qualitätskontrolle gibt es außerdem einen Lint. Dieser automatische Lauf sucht unter anderem nach fehlenden Quellen, toten Querverweisen, verwaisten Seiten und überfälligen Aktualitätsprüfungen. Am 29. August 2026 meldet er zwei tote Querverweise, eine verwaiste Seite und 23 Seiten, deren eingetragenes Aktualisierungsdatum mehr als 90 Tage zurückliegt.
Die beiden vermeintlich toten Links führen allerdings auf Wiki-Seiten, deren Dateinamen von den verwendeten Alias-Namen abweichen. Hier liegt wahrscheinlich ein Fehler in der Prüfung vor. Die Seite zu Query Templates ist dagegen tatsächlich verwaist, weil keine andere Wiki-Seite auf sie verweist. Ein Lint kann somit Probleme aufspüren. Seine Meldungen müssen dennoch einzeln geprüft werden.
Claude und Codex greifen auf denselben Bestand zu
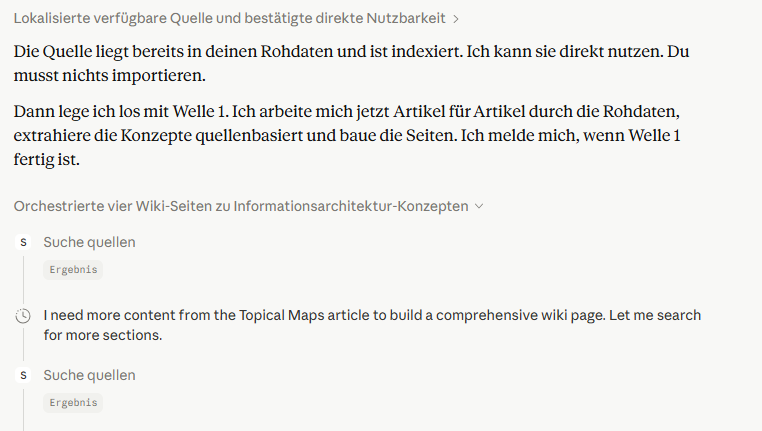
Auf die Bibliothek greife ich inzwischen mit Claude und Codex zu. Ermöglicht wird dies durch das Model Context Protocol, kurz MCP. Nach der MCP-Spezifikation für Werkzeuge kann ein Server definierte Funktionen bereitstellen, die ein kompatibler KI-Client aufrufen darf. Meine Funktionen suchen Quellen, lesen Wiki-Seiten oder starten den Lint.
Schreibende Werkzeuge existieren ebenfalls. Dass ein Tool technisch verfügbar ist, bedeutet jedoch noch nicht, dass jeder Aufruf automatisch erlaubt sein sollte. Änderungen am Wiki bleiben deshalb an einen von mir ausgelösten Arbeitsablauf und eine konkrete Kontrolle gebunden. Die MCP-Dokumentation empfiehlt für derartige Werkzeuge ebenfalls eine menschliche Eingriffsmöglichkeit.
Durch diese Trennung sind Rohquellen, Wiki und Suchindex nicht in einem einzelnen Chat eingeschlossen. Beide Agenten können denselben lokalen Bestand verwenden. Ob sie dieselben Fundstellen auswählen und gleich einordnen, ist damit allerdings nicht garantiert. Der gemeinsame Zugriff schafft eine einheitliche Datenbasis, keine identischen Antworten.
Technische Fehler gehörten von Anfang an dazu
Beschreibt man das fertige System, klingt der Aufbau geordneter, als er tatsächlich war. Bereits bei der Installation von Python hatte ich die Option „Add to PATH“ übersehen. Windows fand Python anschließend nicht. Gelöst wurde das Problem über die Umgebungsvariablen, deren Bedienung für einen Nicht-Programmierer ungefähr so intuitiv war, wie es sich anhört.
Bei der ersten Quelle verwendete ich danach die falsche Domain eines Autors. Die richtige Website lieferte komprimierte Daten in einem Format, das mein Skript nicht verarbeiten konnte. Nach der nächsten Korrektur ließ sich die Seite laden, der eigentliche Artikeltext wurde wegen einer abweichenden HTML-Struktur jedoch weiterhin nicht erkannt.
Claude schrieb daraufhin ein Diagnose-Skript, untersuchte die Seite und passte die Auswahl des Artikelinhalts an. Beim späteren Import wiederholte sich dieses Muster. Eine YouTube-API hatte sich verändert. JavaScript-lastige Seiten lieferten leere Dokumente, weil ihr Inhalt erst im Browser aufgebaut wurde. Für solche Websites musste ein Browser im Hintergrund die Seite vollständig laden.
Auch die inkrementelle Indexierung benötigte mehrere Anläufe. Zuerst sollte das Änderungsdatum einer Datei anzeigen, ob sie neu verarbeitet werden muss. Der Import schrieb die Dateien allerdings bei jedem Lauf neu und veränderte damit ausgerechnet dieses Datum. Danach wurde der Fortschritt erst am Ende des gesamten Durchlaufs gespeichert. Brach der Import vorher ab, war der Zwischenstand verloren.
Funktioniert hat schließlich eine Prüfsumme des Dateiinhalts, die nach jeder verarbeiteten Quelle gespeichert wird. Programmieren hätte ich diese Lösung nicht selbst können. Beschreiben konnte ich hingegen, was passiert war, welches Verhalten ich erwartet hatte und welche Fehlermeldung angezeigt wurde. Auf dieser Grundlage ließ sich das Problem Schritt für Schritt bearbeiten.
Karpathys LLM Wiki löst ein ähnliches Problem
Am 4. April 2026 veröffentlichte Andrej Karpathy auf GitHub sein Idea File „LLM Wiki“. Zu diesem Zeitpunkt lief meine Bibliothek bereits in einer ersten funktionsfähigen Version. Interessiert hat mich daher, wie ähnlich die Ausgangsprobleme und wie unterschiedlich einzelne Lösungen waren.
Karpathy beschreibt drei Schichten. Unveränderliche Rohquellen bilden die Grundlage. Darüber liegt ein Wiki aus miteinander verbundenen Markdown-Dateien. Ein Schema in einer Anweisungsdatei legt fest, wie der Agent Quellen einliest, Seiten aktualisiert und Fragen beantwortet. Bei einem neuen Dokument soll der Agent relevante Wiki-Seiten ergänzen, Widersprüche festhalten und Querverweise pflegen.
Für einen mittleren Bestand von ungefähr 100 Quellen und mehreren hundert Wiki-Seiten hält Karpathy einen gepflegten Index zunächst für ausreichend. Als optionale Erweiterung nennt die aktuelle Version seines Gists eine lokale Suche mit BM25, Vektorsuche und LLM-Reranking. Seine Veröffentlichung dokumentiert damit ein flexibles Muster und keine fertige Software, die unverändert installiert werden kann.
Meine Bibliothek ist unabhängig davon entstanden und setzt die Suchschicht wegen des bereits größeren Rohbestands stärker ein. Einen besonderen Anspruch leite ich aus der zeitlichen Nähe nicht ab. Für mich zeigt sie vor allem, dass eine reine Dokumentensuche und ein dauerhaft gepflegter Wissensstand zwei verschiedene Aufgaben lösen.
Quellengebunden bedeutet nicht fehlerfrei
Mit der Bibliothek kann ich eine Fachfrage stellen und erhalte konkrete Passagen aus meinen Quellen. Zu jeder Fundstelle werden Dokument, Abschnitt und Herkunft angezeigt. Dadurch lässt sich eine Antwort leichter prüfen als eine Zusammenfassung, bei der die verwendeten Textstellen unsichtbar bleiben.
Fehler entstehen trotzdem an mehreren Stellen. Das Retrieval kann einen relevanten Absatz übersehen. Der Cross-Encoder kann einen weniger geeigneten Chunk bevorzugen. Anschließend kann ein Sprachmodell die Fundstellen falsch zusammenfassen oder eine weitergehende Schlussfolgerung formulieren, die durch die Quelle nicht gedeckt ist.
Bei SEO-Recherchen kommt die unterschiedliche Aussagekraft der Dokumente hinzu. Eine offizielle Dokumentation kann veröffentlichte Produktfunktionen und formale Anforderungen beschreiben. Ein Patent belegt zunächst eine angemeldete technische Idee. Gerichtsunterlagen können interne Systeme dokumentieren, erfassen aber ebenfalls nur den jeweiligen Verfahrensgegenstand. Fallstudien und Praktikermodelle liefern weitere Perspektiven, ohne dadurch die vollständige Funktionsweise einer Suchmaschine zu beweisen.
Ein weiteres Risiko entsteht durch Zirkelschlüsse. Einige Wiki-Seiten verwenden eigene Blogartikel als Quelle. Würde ich diese Artikel später ausschließlich mit dem Wiki prüfen, könnten sie sich selbst bestätigen. Für ein fachliches Lektorat gehe ich deshalb bis zur ursprünglichen externen Quelle zurück und prüfe zusätzlich, ob neuere Informationen vorliegen.
Die Suchinfrastruktur läuft lokal auf meinem Windows-Rechner und benötigt keine eigene GPU. Externe Kosten können dennoch entstehen, wenn ein Sprachmodell Quellen verarbeitet, Wiki-Seiten überarbeitet oder Antworten formuliert. Ebenso bleiben Datenschutz und Zugriffsrechte relevant. Lokal gespeicherte Dateien sind nicht automatisch vor jedem Zugriff geschützt, sobald externe Modelle in einen Arbeitsablauf eingebunden werden.
Was ich ohne Programmierkenntnisse gelernt habe
Ohne Claude hätte ich diese SEO-Wissensbibliothek nicht bauen können. Zum Programmierer bin ich dadurch weiterhin nicht geworden. Gelernt habe ich allerdings, technische Probleme so zu beschreiben, dass ein Coding-Agent sinnvoll damit arbeiten kann.
Zu diesem Zweck musste ich das erwartete Verhalten benennen, Fehler reproduzieren, Ausgaben vergleichen und nach jeder Änderung erneut testen. Funktionierender Code war dabei nur ein Zwischenschritt. Ob ein Import den richtigen Artikeltext erfasst, eine Suche die brauchbare Passage findet oder eine Wiki-Seite eine Quelle sauber einordnet, bleibt eine fachliche Frage.
Heute ist die Bibliothek für mich deshalb vor allem ein Recherche-Instrument. Sie verkürzt den Weg zu meinen Quellen und bewahrt bereits erarbeitete Zusammenhänge. Vertrauen muss ich dem Sprachmodell deswegen weiterhin nicht blind. Ich kann nachsehen, welche Quelle gefunden wurde, was dort steht und an welcher Stelle meine eigene Interpretation beginnt.
Über diesen Artikel
Die inhaltliche Verantwortung für jeden Artikel auf diesem Blog liegt bei mir, Patrick Stolp. Thema, These, Recherche und fachliche Prüfung sind meine Arbeit – hier wird nichts veröffentlicht, das ich nicht selbst konzipiert, geschrieben und als korrekt verifiziert habe. Generative KI (Claude von Anthropic) kommt punktuell als Werkzeug zum Einsatz – etwa für Formulierungsentwürfe oder das Gegenlesen technischer Erklärungen. Kein KI-Output landet ungeprüft oder unverändert auf dieser Seite. Beitragsbilder werden mit Google Nano Banana 2 erstellt.
Mehr dazu in meinen Redaktionsrichtlinien.